こんにちは、LIFULLでUXリサーチャーをしている小川です。
LIFULLは「RESEARCH Conference」の初回から継続してスポンサーを務めておりますが、今年はありがたいことに、スポンサー枠とは別にポスターセッションへの発表機会もいただくことができました。
2026年6月28日に開催された「 RESEARCH Conference 2026 」のテーマは「WEAVING」。このカンファレンスのテーマに合わせ、私たちは「『眠れる資産』を『生きたユーザー』として呼び覚ます」というタイトルで発表を行いました。当日使用したポスターの全体像は、こちらからご覧ください。
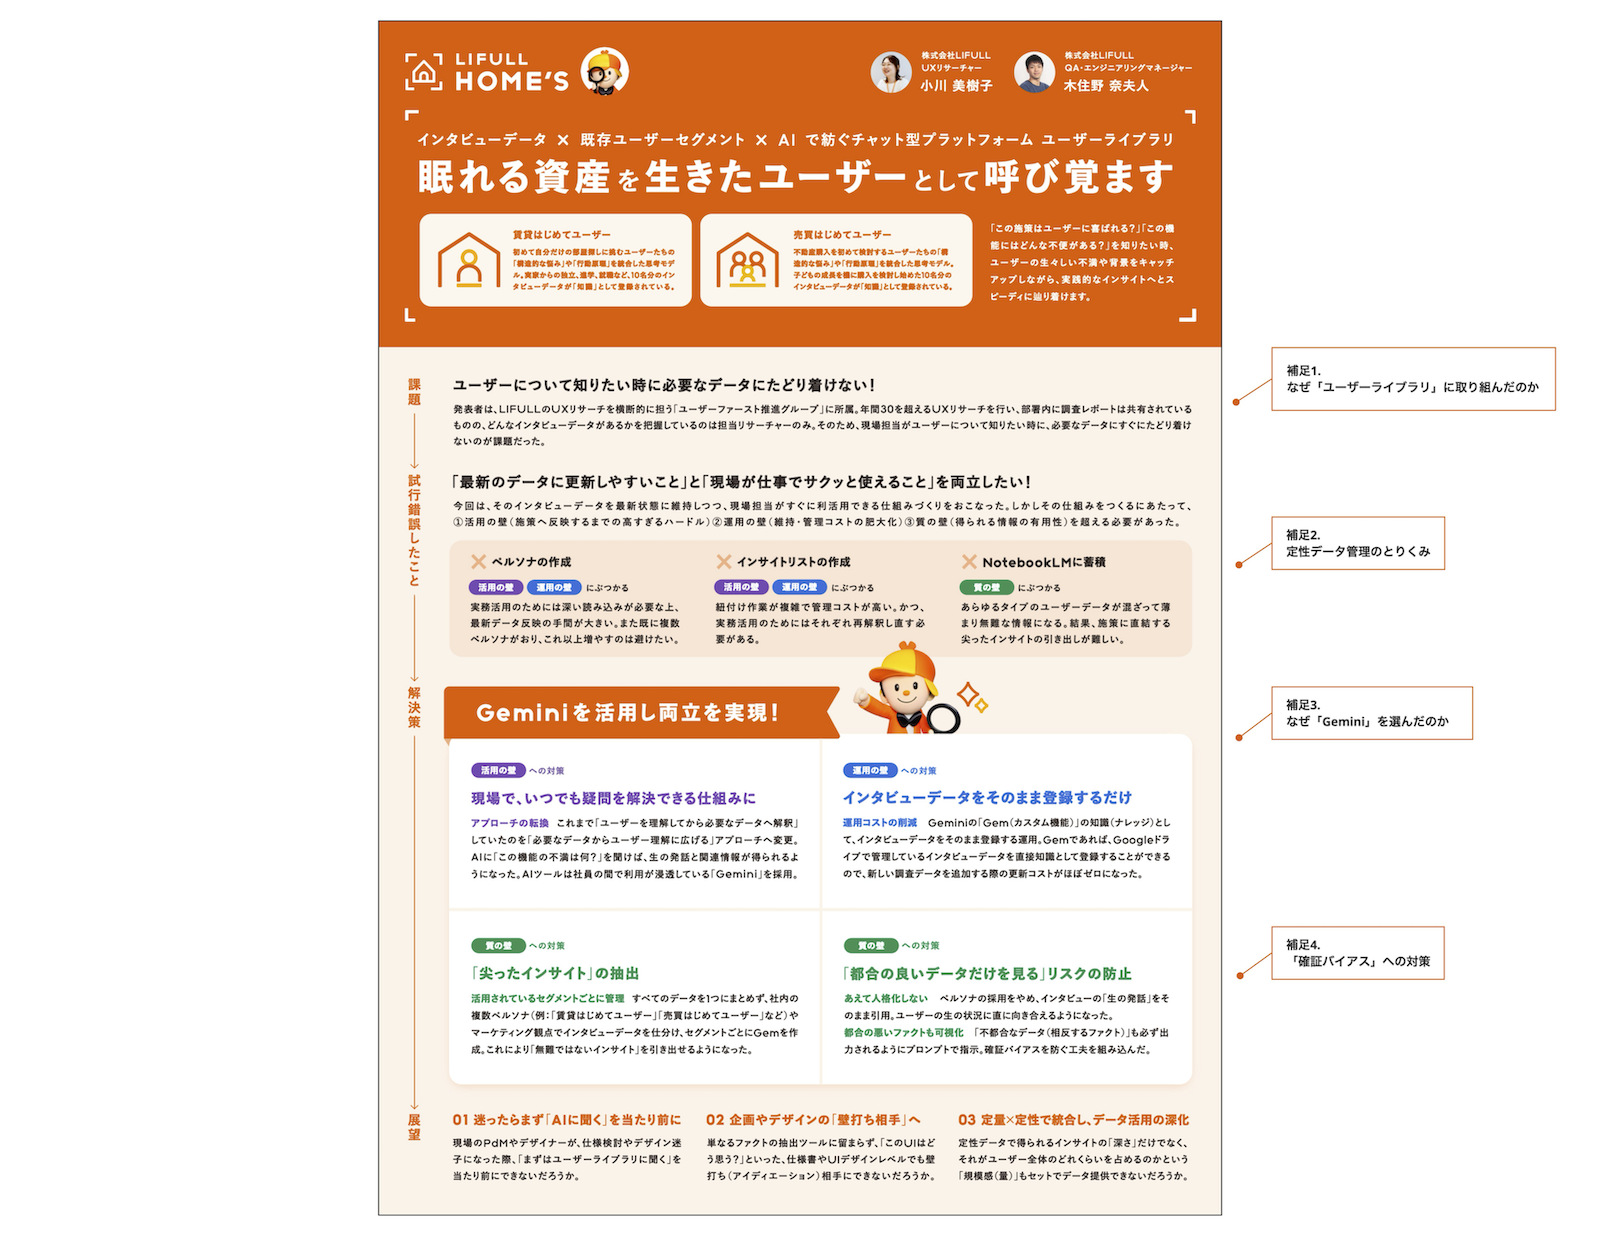
今回発表したのは、過去の調査データを眠らせたままにせず、日々の業務に活かすための「ユーザーライブラリ」という取り組みです。
インタビューデータと既存ユーザーセグメントを組み合わせ、生成AIを活用することで、開発現場のメンバーがいつでも手軽にリサーチデータを引き出せる仕組みをつくりました。
この記事では、限られた時間の中ではお伝えしきれなかった背景や、当日よくいただいたご質問について、少し深掘りして補足させてください。
当日話しきれなかったポスターの補足
補足1. なぜ「ユーザーライブラリ」に取り組んだのか?
私が所属するユーザーファースト推進グループは、全社横断でUXリサーチを行っている組織です。普段は開発チームからの依頼を受けて調査やレポート作成を行っています。
これまで数多くのインタビュー調査を行ってきましたが、集めた内容のすべてが調査レポートに活用されるわけではありません。しかし、それらは決して無駄なデータではなく、別の視点で見れば、新規調査が不要になるほど価値あるデータであるケースも多くあります。
このような「今回の調査目的には不要でも、別の文脈では価値があるデータ」を、担当リサーチャーしか辿り着けない状態のまま埋もれさせてしまうのは非常にもったいないと感じていました。
これらを個人の手元で眠らせるのではなく「開発メンバーが活用できる資産」へ生き返らせる。そんな組織のデータ活用に変化を起こすために、今回のプロジェクトを立ち上げました。
補足2. 定性データ管理のとりくみ
現在、定性データを以下の3つのデータソースとして整理し、役割を分けて運用しています。
- 調査レポートソース(NotebookLM):過去の調査結果そのものを蓄積するデータソース。
- インタビュー個票ソース(NotebookLM):発話などの生データをそのまま参照するためのデータソース。
- セグメント別対話AI(Gemini):今回のポスターセッションで焦点を当てた、ユーザーセグメントにフォーカスを絞ったデータソース。
今回の試行錯誤のなかで「今の目的には合わないが、将来的に別の目的で活きる」と判断したデータソースもできました。そのデータソースは今も管理を続けています。
補足3. なぜ「Gemini」を選んだのか
当日「なぜ数ある生成AIの中からGeminiを選んだのですか?」というご質問も多くいただきました。
結論から言うと、ツールの純粋な性能云々というよりも、「私たちの社内環境において最適解」と判断したからです。ツールの選定にあたっては、以下の3つの観点を重視しました。
- 社内アクセス性:開発メンバーやリサーチャーが日常業務で使いやすいツールであること。
- カスタム指示の柔軟性:チームの知見やプロンプトをAIに学習させやすいこと。
- 知識データの指定:Googleドライブ等と連携し、既存のインプット資産を活用しやすいこと。
重要なのは特定のツールに依存することではなく、「どうすれば社内のリサーチデータが活きた資産になるか」という目的そのものです。どんなに優れたAIツールであっても、利用するために複雑な設定や申請が必要なものは最初に除外しました。
現在、私たちはGeminiで運用をしておりますが、同じようなアプローチはNotebookLMでも実現可能ですし、環境さえ整えば他のLLMツールでも同様の仕組みは十分に構築可能です。
補足4. 「確証バイアス」への対策
今回の発表において、参加者の方々から特に多くの共感の声をいただいたのが、解決策のなかでも『「都合の良いデータだけを見る」リスクの防止』に関する取り組みでした。
人はどうしても自分の仮説を後押ししてくれる「都合の良いデータ」ばかりに目が向いてしまいがちです(確証バイアス)。そうした思い込みや視野狭窄に陥るのを防ぐため、今回の仕組みでは、あえて相反するファクトや関連するデータを一緒に提示する工夫を入れました。
「一方向からの情報だけで満足せず、多面的に仮説をブラッシュアップしてもらいたい」という、私自身の強い気持ちから生まれた対策です。
おわりに
まずは、当日のタイトなスケジュールのなか、私たちのポスターブースに足を運んでくださった皆さま、本当にありがとうございました!
コアタイム以外でも熱心に議論が続き、多角的な視点でフィードバックをいただけたことは、私自身とても大きな学びとなりました。温かいコメントや鋭いご指摘のすべてが、今後の励みになります。皆さまからいただいたヒントを胸に、今後も取り組みをブラッシュアップしてまいります。
今回の発表を通じ、多くのチームが私たちと同じように「リサーチデータの活用」に頭を悩ませているのだと強く実感しました。またどこかのカンファレンスでお会いした際は、ぜひ情報交換をさせてください!
運営スタッフの皆さまにも心より感謝申し上げます。引き続き、リサーチデータを「眠らせない」ための工夫を現場で続けていきたいと思います。
LIFULLでは共に成長できるような仲間を募っています。よろしければこちらのページもご覧ください。
